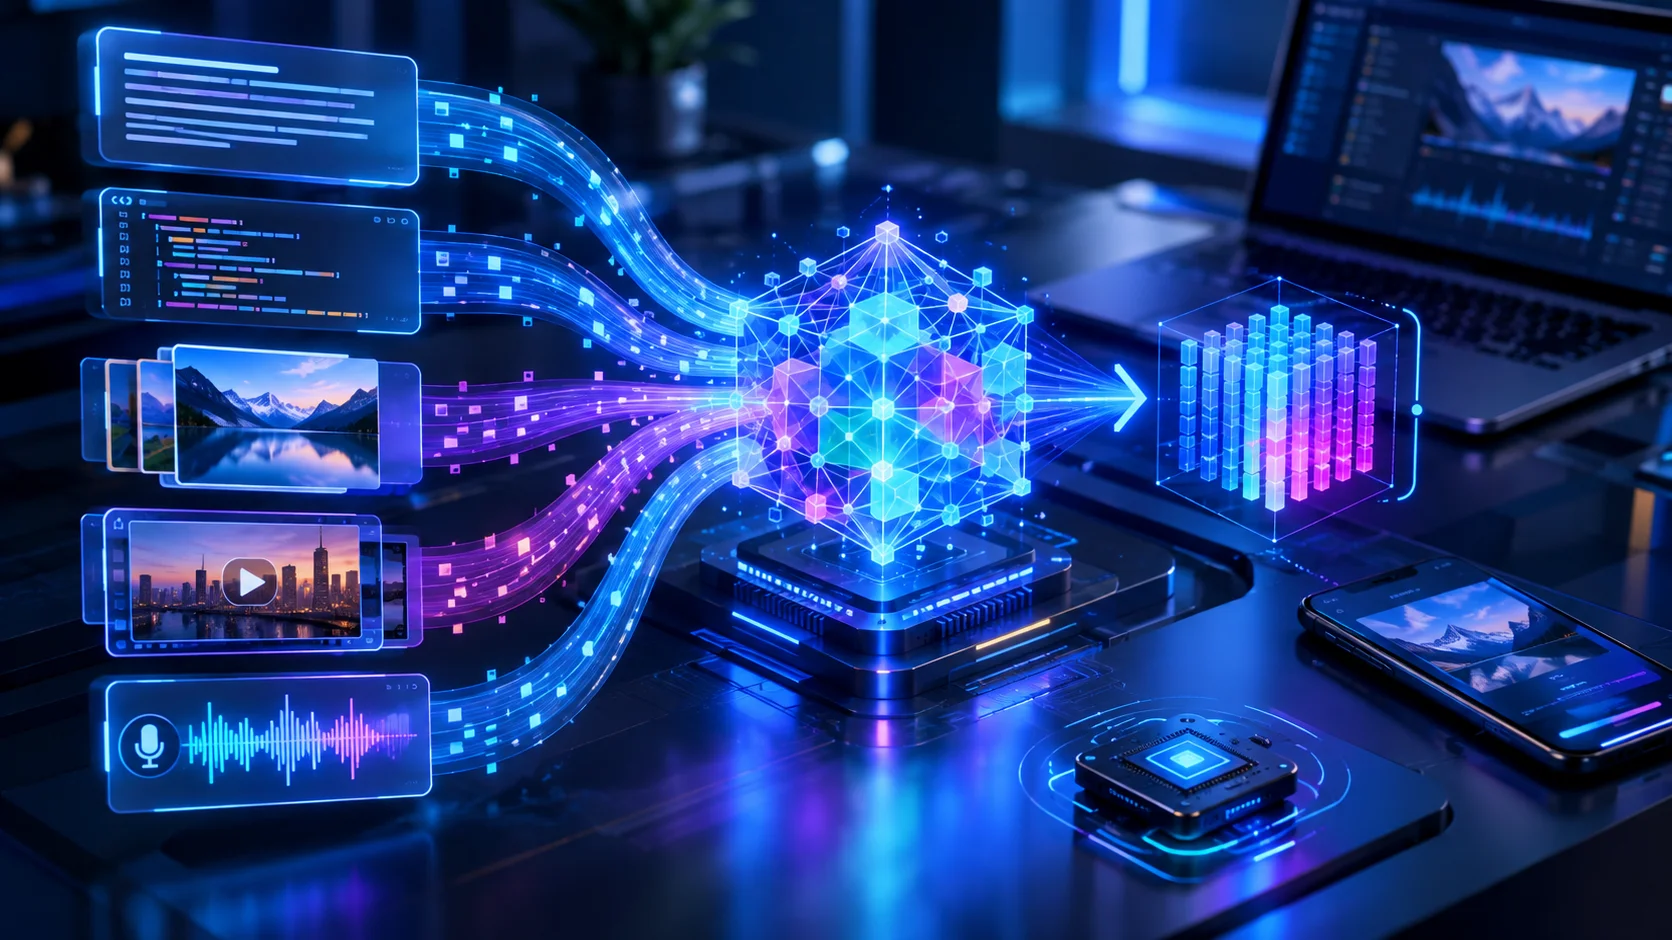
گوگل EmbeddingGemma 2 را معرفی کرده است؛ یک مدل embedding چندوجهی با ۷۴۰ میلیون پارامتر که متن، کد، تصویر، ویدئو و صدا را در یک فضای برداری مشترک قرار میدهد. مهمترین ویژگی این مدل، تمرکز روی اجرای محلی و کممصرف است. به همین دلیل، توسعهدهندگان میتوانند قابلیتهایی مانند جستوجوی معنایی، بازیابی اطلاعات و RAG را مستقیماً روی گوشی، لپتاپ و دیگر دستگاههای مصرفی اجرا کنند.
EmbeddingGemma 2 برخلاف مدلهای مولد، متن تولید نمیکند. این مدل ارتباط معنایی میان دادهها را پیدا میکند و اطلاعات مختلف را به بردارهای عددی تبدیل میکند. سپس سیستم با مقایسه این بردارها، دادههای مشابه یا مرتبط را پیدا میکند. همین معماری، مدل جدید گوگل را برای جستوجوی عکس و ویدئو، بازیابی فایلهای صوتی، جستوجوی کد، دستهبندی اطلاعات و ساخت سیستمهای RAG مناسب میکند.
📌 EmbeddingGemma 2 چیست؟
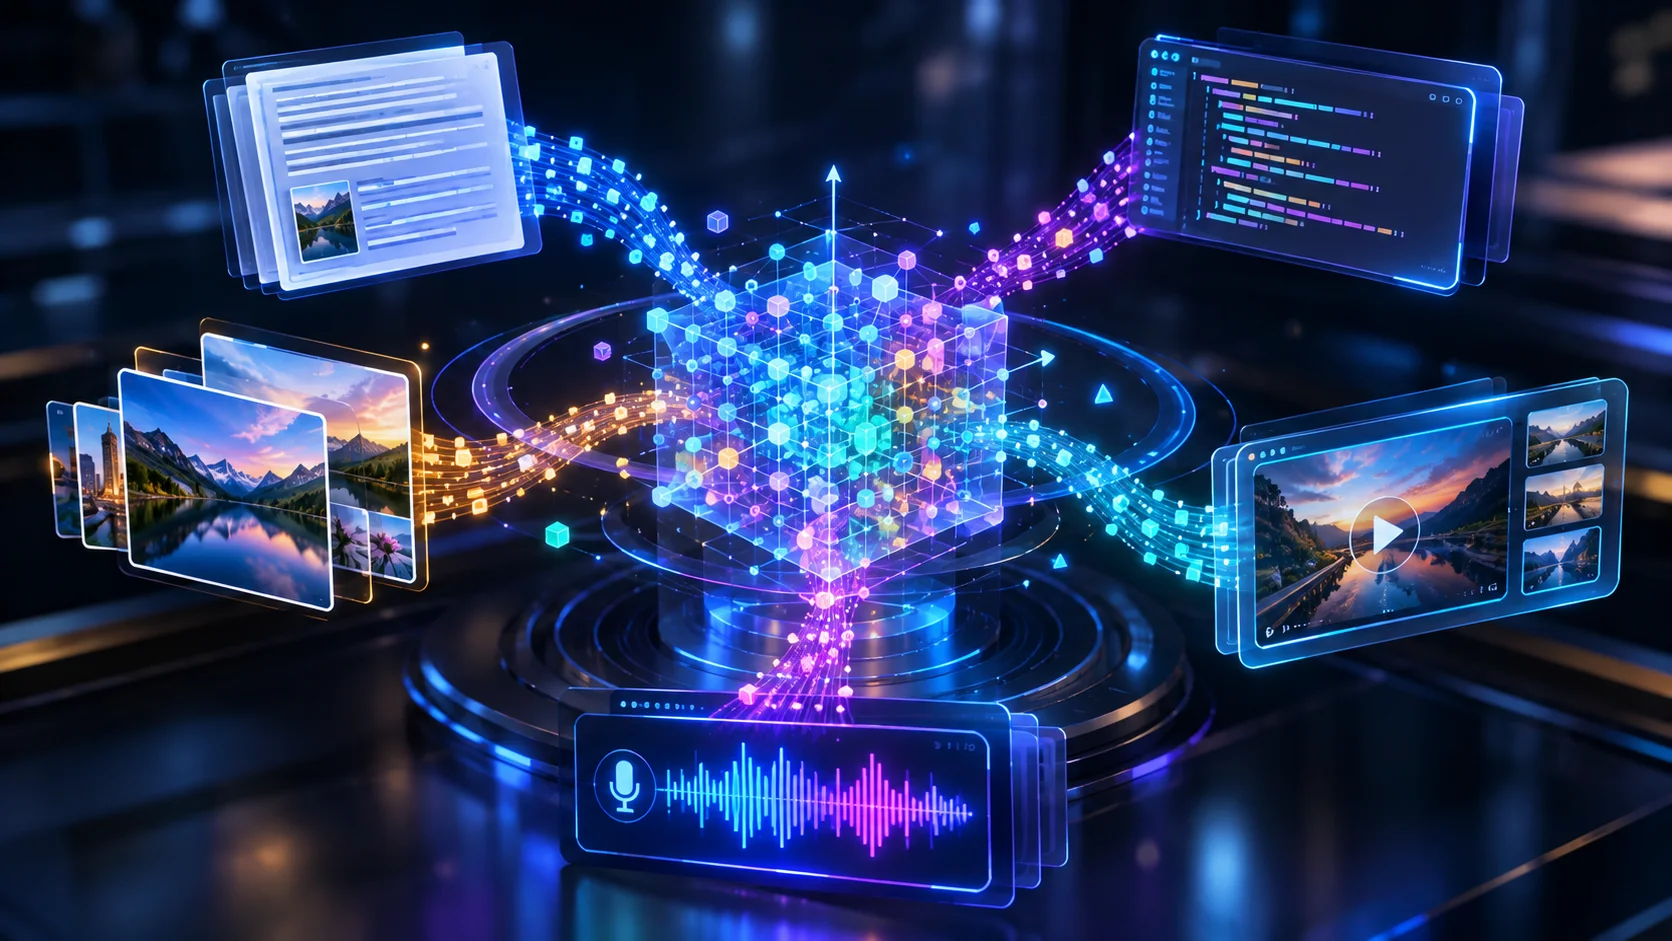
EmbeddingGemma 2 یک مدل multimodal embedding از Google DeepMind است که بر پایه فناوری و معماری Gemma 4 توسعه پیدا کرده است. مدل، متن، کد، تصویر، ویدئو و صدا را دریافت میکند و خروجی آنها را در یک فضای embedding مشترک ۷۶۸بعدی قرار میدهد.
برای درک کاربرد آن، یک گالری بزرگ را تصور کنید. هزاران عکس، فایل صوتی و ویدئو روی گوشی ذخیره شدهاند و کاربر میخواهد یکی از آنها را پیدا کند. جستوجوی معمولی بیشتر سراغ نام فایل، پوشه یا تاریخ میرود. EmbeddingGemma 2 میتواند محتوای این دادهها را نیز بررسی کند و برای هر مورد یک نمایش برداری بسازد.
حالا کاربر عبارت «عکسهای ساحل که در آنها سگ دیده میشود» را وارد میکند. سیستم ابتدا عبارت جستوجو را به embedding تبدیل میکند. بعد، vector مربوط به query را با vectorهای تصاویر مقایسه میکند. در نهایت، نتایجی که بیشترین شباهت معنایی را دارند، رتبه بالاتری میگیرند.
یک نکته مهم را باید در نظر گرفت: EmbeddingGemma 2 چتبات نیست. مدل بهجای تولید پاسخهای طولانی، دادهها را برای جستوجو، بازیابی و مقایسه معنایی آماده میکند. کاربردهایی مانند search، retrieval، RAG، classification، clustering و semantic similarity در همین دسته قرار میگیرند.
⚡ چرا EmbeddingGemma 2 مهم است؟
قرار دادن چند نوع داده در یک فضای embedding مشترک، مهمترین مزیت EmbeddingGemma 2 محسوب میشود. گوگل با این مدل امکان ارتباط میان متن، تصویر، ویدئو و صدا را در یک سیستم واحد فراهم کرده است.
این ساختار، محدودیت جستوجوی تکوجهی را کاهش میدهد. برای مثال، یک عبارت متنی میتواند تصویر مرتبط را پیدا کند یا یک فایل صوتی به پیدا کردن بخش مشخصی از یک ویدئو کمک کند.
اجرای مدل روی خود دستگاه نیز اهمیت زیادی دارد. پردازش محلی، وابستگی سیستم به سرورهای ابری را کاهش میدهد و میتواند تأخیر شبکه را از مسیر جستوجو حذف کند. چنین معماریای برای دادههای شخصی نیز جذاب است، زیرا توسعهدهنده میتواند بخش مهمی از فرایند پردازش را داخل دستگاه نگه دارد.
البته نباید «on-device» را با «هر اپلیکیشنی کاملاً آفلاین است» یکی دانست. خود مدل میتواند بدون اتصال اینترنت inference انجام دهد، اما یک برنامه ممکن است برای قابلیتهای دیگر همچنان به سرویس آنلاین نیاز داشته باشد.
🧩 EmbeddingGemma 2 چه دادههایی را پردازش میکند؟
EmbeddingGemma 2 چهار نوع ورودی اصلی را به شکل بومی پشتیبانی میکند:
- متن و کد
- تصویر
- ویدئو
- صدا
مدل همه این ورودیها را در یک فضای embedding مشترک ۷۶۸بعدی قرار میدهد. بنابراین توسعهدهنده میتواند ارتباط معنایی میان دادههایی با ماهیت متفاوت را بررسی کند.
متن و کد
جستوجوی معنایی یکی از کاربردهای اصلی بخش متنی مدل محسوب میشود. توسعهدهنده میتواند اسناد مختلف را به embedding تبدیل کند و سپس با مقایسه vectorها، محتوای مرتبط را پیدا کند.
کد نیز در همین بخش قرار میگیرد. یک ابزار توسعه نرمافزار میتواند توضیح طبیعی کاربر را با بخشهای مختلف یک codebase مقایسه کند و قسمتهایی را پیدا کند که از نظر معنایی بیشترین ارتباط را دارند.
گوگل در ارزیابی MTEB Code امتیاز ۷۸.۶۸ را برای EmbeddingGemma 2 ثبت کرده است. نسخه قبلی این خانواده در همان benchmark امتیاز ۶۸.۷۶ داشت؛ بنابراین مدل جدید ۹.۹۲ امتیاز پیشرفت کرده است.
تصویر
سیستم میتواند تصاویر را به embedding تبدیل کند و آنها را در یک پایگاه داده برداری نگه دارد. بعد از آن، کاربر با متن یا حتی یک تصویر دیگر جستوجو را انجام میدهد.
در این روش، نام فایل تنها معیار جستوجو نیست. محتوای بصری نیز در رتبهبندی نتایج نقش دارد. همین قابلیت برای گالریهای شخصی، آرشیوهای تصویری و سرویسهای مدیریت محتوا کاربرد زیادی دارد.
ویدئو
EmbeddingGemma 2 از ویدئو نیز پشتیبانی میکند و میتواند برای پیدا کردن لحظههای خاص در فایلهای ویدئویی به کار برود.
برای مثال، کاربر عبارت «قسمتی که فرد کنار خودرو ایستاده است» را وارد میکند. سیستم query را به embedding تبدیل میکند و آن را با embedding بخشهای مختلف ویدئو مقایسه میکند. نتیجه میتواند نمایش همان لحظه یا timestamp مرتبط باشد.
گوگل در نمونه Video Moments Finder همین ایده را روی ویدئوهای محلی نشان داده است. این ابزار میتواند با query متنی یا صوتی، لحظههای مشخصی را در فایل ویدئویی پیدا کند.
صدا
Encoder صوتی مدل، فایلهای صوتی را به embedding تبدیل میکند. چنین قابلیتی برای آرشیو جلسات، مصاحبهها، یادداشتهای صوتی و جستوجوی محتوای صوتی کاربرد دارد.
تصور کنید کاربر بخواهد جلسهای را پیدا کند که در آن درباره «طراحی محصول جدید» صحبت شده است. سیستم میتواند query را با embedding فایلهای صوتی مقایسه کند و موارد مرتبط را بالاتر قرار دهد.
📱 اجرای آفلاین EmbeddingGemma 2 روی گوشی چگونه است؟
EmbeddingGemma 2 از ابتدا با هدف اجرای محلی روی سختافزارهای مصرفی مانند گوشی و لپتاپ توسعه پیدا کرده است. این مدل میتواند embedding را روی دستگاه تولید کند و برای جستوجو و retrieval به سرور ابری وابسته نباشد.
گوگل اجرای نسخه quantized مدل را روی Pixel 11 Pro نیز آزمایش کرده است. نسخه text-only در این آزمایش حدود ۱۹۱ مگابایت RAM فعال مصرف کرد. نسخه کامل چندوجهی نیز حدود ۵۶۷ مگابایت RAM فعال نیاز داشت.
این اعداد نشان میدهند که مدلهای embedding چندوجهی میتوانند روی سختافزارهای مصرفی اجرا شوند. البته مصرف واقعی به دستگاه، quantization، نوع ورودی و بخشهای فعال مدل بستگی دارد.
از طرف دیگر، توسعهدهنده میتواند فقط encoderهای مورد نیاز خود را فعال کند. چنین طراحی ماژولاری مصرف حافظه را کاهش میدهد و اجرای مدل را برای سناریوهای مختلف سادهتر میکند.
🔢 EmbeddingGemma 2 چند پارامتر دارد؟
EmbeddingGemma 2 در مجموع ۷۴۰ میلیون پارامتر دارد. گوگل معماری مدل را به شکل ماژولار طراحی کرده تا توسعهدهنده بتواند متناسب با نیاز خود بخشهای مختلف را فعال کند.
| بخش مدل | تعداد پارامتر |
|---|---|
| مدل متنی | ۲۷۰ میلیون |
| Encoder بینایی | ۱۷۰ میلیون |
| Encoder صوتی | ۳۰۰ میلیون |
| مجموع | ۷۴۰ میلیون |
مدل متنی بهتنهایی حدود ۲۷۰ میلیون پارامتر دارد. اضافه کردن encoder بینایی، قابلیت پردازش تصویر و ویدئو را وارد معماری میکند. Encoder صوتی نیز ۳۰۰ میلیون پارامتر دیگر به حالت کامل اضافه میکند.
در نتیجه، حالت text-only حدود ۲۷۰ میلیون پارامتر دارد. ترکیب متن و تصویر به حدود ۴۴۰ میلیون پارامتر میرسد و استفاده از همه بخشها، مجموع ۷۴۰ میلیون پارامتر را فعال میکند.
این ساختار ماژولار یک مزیت مهم برای دستگاههای کممصرف محسوب میشود. یک اپلیکیشن جستوجوی متنی نیازی ندارد encoder تصویر و صدا را همزمان بارگذاری کند.
🧠 ویژگیهای کلیدی EmbeddingGemma 2
EmbeddingGemma 2 علاوه بر چندوجهی بودن، چند قابلیت فنی دیگر هم ارائه میدهد. این ویژگیها به توسعهدهندگان کمک میکنند مدل را برای جستوجو و retrieval محلی بهتر با نیاز پروژه هماهنگ کنند.
فضای embedding مشترک ۷۶۸بعدی
مدل خروجی دادههای مختلف را در یک فضای مشترک ۷۶۸بعدی قرار میدهد. این طراحی امکان مقایسه مستقیم دادههایی مانند متن و تصویر را فراهم میکند.
برای نمونه، سیستم میتواند embedding عبارت «گربهای که روی مبل خوابیده» را با embedding تصاویر مقایسه کند. هرچه فاصله معنایی کمتر باشد، احتمال ارتباط دادهها بیشتر خواهد بود.
پشتیبانی از بیش از ۱۰۰ زبان
EmbeddingGemma 2 بیش از ۱۰۰ زبان را پوشش میدهد. این ویژگی برای سرویسهایی که کاربران چندزبانه دارند اهمیت زیادی دارد.
البته کیفیت مدل در همه زبانها الزاماً یکسان نیست. بنابراین توسعهدهنده باید زبان و نوع داده پروژه را در benchmarkهای مربوط به همان کاربرد بررسی کند.
پنجره context هشتهزار و ۱۹۲ توکنی
مدل یک context window برابر با ۸۱۹۲ توکن دارد. این ظرفیت نسبت به EmbeddingGemma نسل اول چهار برابر بیشتر است.
ظرفیت موردنظر فقط به متن اختصاص ندارد. مدل میتواند در شرایط مشخص حدود ۵.۵ دقیقه صوت، ۲۹ تصویر یا ۵۸ فریم ویدئو را پردازش کند. ترکیب چند نوع ورودی نیز بخشی از همین ظرفیت را مصرف خواهد کرد.
Matryoshka Representation Learning
Matryoshka Representation Learning یا MRL به توسعهدهنده اجازه میدهد خروجی ۷۶۸بعدی را به ابعاد پایینتر مانند ۵۱۲، ۲۵۶ یا ۱۲۸ برش دهد.
این قابلیت برای پایگاههای داده برداری بزرگ اهمیت زیادی دارد. کاهش ابعاد، حجم ذخیرهسازی و footprint ایندکس را پایین میآورد. گوگل اعلام کرده است که این روش میتواند فضای ذخیرهسازی محلی را تا چند برابر کاهش دهد.
در مقابل، کاهش تعداد ابعاد ممکن است بخشی از کیفیت بازیابی را کم کند. بنابراین انتخاب ۷۶۸، ۵۱۲، ۲۵۶ یا ۱۲۸ بُعد باید بر اساس نیاز پروژه انجام شود.
🔍 EmbeddingGemma 2 چه کاربردهایی دارد؟
EmbeddingGemma 2 بیشتر نقش یک لایه زیرساختی را در اپلیکیشنهای هوش مصنوعی ایفا میکند. کاربر نهایی شاید نام مدل را نبیند، اما نتیجه کار آن را در قابلیتهایی مانند جستوجوی هوشمند تجربه خواهد کرد.
جستوجوی هوشمند عکسها
یک گالری با هزاران تصویر را در نظر بگیرید. کاربر عبارت «عکسهای سفر شمال کنار دریا» را وارد میکند.
سیستم ابتدا query را به embedding تبدیل میکند. بعد، vector مربوط به query را با vector تصاویر مقایسه میکند. در نهایت، تصاویر مرتبطتر را بالاتر قرار میدهد.
این روش نسبت به جستوجوی نام فایل انعطاف بیشتری دارد. کاربر به جای دانستن نام عکس، مفهوم موردنظر خود را بیان میکند.
پیدا کردن بخش خاصی از ویدئو
آرشیوهای ویدئویی بزرگ، پیدا کردن یک لحظه مشخص را دشوار میکنند. EmbeddingGemma 2 میتواند برای این مسئله نقش موتور retrieval را بر عهده بگیرد.
کاربر عبارتی مانند «بخشی که سخنران درباره هوش مصنوعی صحبت میکند» را وارد میکند. سیستم query را با embedding فریمها یا بخشهای مرتبط مقایسه میکند و timestampهای مناسب را برمیگرداند.
Google AI Edge چنین قابلیتی را در Video Moments Finder نمایش داده است. این نمونه، جستوجوی معنایی در ویدئو را مستقیماً روی دستگاه اجرا میکند.
جستوجوی فایلهای صوتی
جلسات، مصاحبهها و یادداشتهای صوتی نیز میتوانند در یک سیستم retrieval قرار بگیرند.
برای مثال، کاربر میگوید «فایل جلسهای را پیدا کن که درباره طراحی محصول جدید صحبت کردیم». سیستم query را به embedding تبدیل میکند و فایلهای صوتی مرتبط را رتبهبندی میکند.
جستوجوی کد
توسعهدهندگان میتوانند EmbeddingGemma 2 را برای جستوجوی معنایی در codebase نیز به کار بگیرند.
در این روش، سیستم فقط به دنبال نام دقیق یک تابع نیست. ارتباط معنایی میان توضیح کاربر و بخشهای مختلف کد را نیز بررسی میکند. چنین قابلیتی برای پروژههای بزرگ و ابزارهای coding agent کاربرد ویژهای دارد.
🛠️ EmbeddingGemma 2 برای RAG چه کاربردی دارد؟
RAG یا Retrieval-Augmented Generation یکی از مهمترین کاربردهای مدلهای embedding محسوب میشود.
در یک سیستم RAG، توسعهدهنده ابتدا اسناد را به embedding تبدیل میکند. سپس vectorها را در یک پایگاه داده برداری ذخیره میکند. هنگام پرسش کاربر، سیستم query را نیز به embedding تبدیل میکند و اسناد مرتبط را از پایگاه داده بیرون میکشد.
فرایند کلی چنین ساختاری را میتوان اینطور نمایش داد:
سند → Embedding → Vector Database → Retrieval → مدل مولد → پاسخ
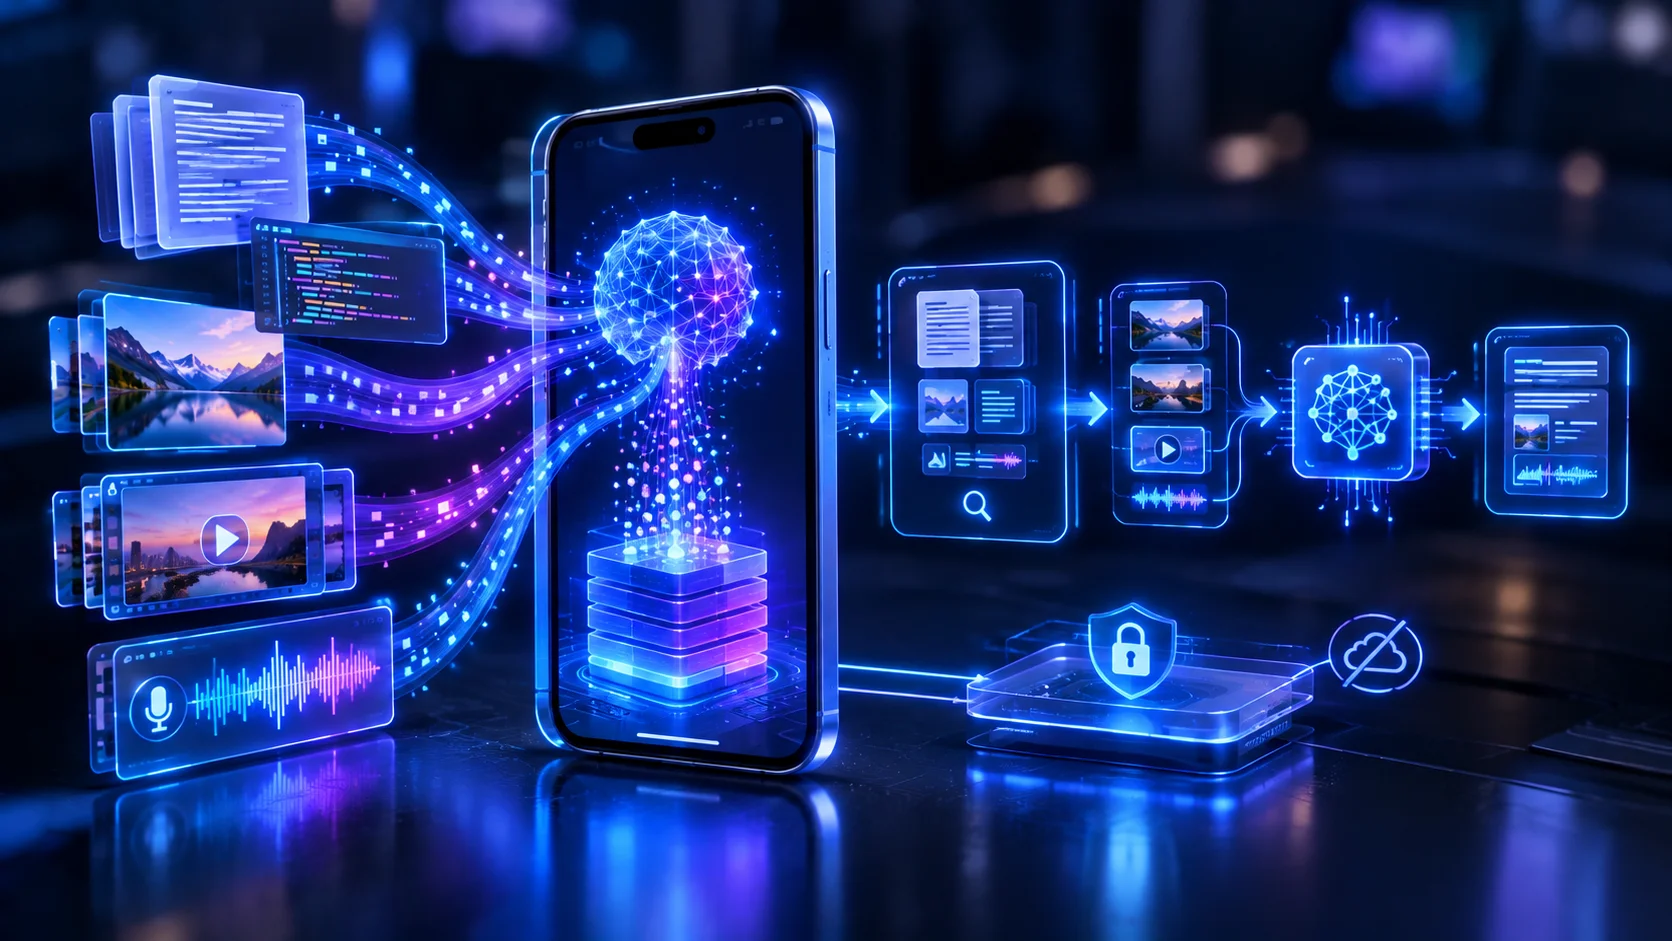
EmbeddingGemma 2 بخش embedding و retrieval این زنجیره را انجام میدهد. یک مدل مولد مانند Gemma 4 نیز میتواند بعد از retrieval، اطلاعات پیداشده را بررسی کند و پاسخ نهایی را بسازد. گوگل نیز ترکیب EmbeddingGemma 2 با مدلهای مولد Gemma را برای ساخت RAG روی دستگاه پیشنهاد کرده است.
این ترکیب، امکان ساخت سیستمهایی را فراهم میکند که اسناد، تصاویر، فایلهای صوتی و دیگر دادههای شخصی را محلی جستوجو میکنند.
🔄 تفاوت EmbeddingGemma 2 با EmbeddingGemma چیست؟
نسل اول EmbeddingGemma تمرکز اصلی خود را روی embedding متنی گذاشته بود. نسخه دوم دامنه ورودیها را گسترش داده و یک معماری چندوجهی ارائه میکند.
| ویژگی | EmbeddingGemma | EmbeddingGemma 2 |
|---|---|---|
| تمرکز اصلی | Embedding متنی | Embedding چندوجهی |
| متن | دارد | دارد |
| کد | دارد | دارد |
| تصویر | ندارد | دارد |
| ویدئو | ندارد | دارد |
| صدا | ندارد | دارد |
| فضای embedding مشترک چندوجهی | ندارد | دارد |
| Context window | کوچکتر | ۸۱۹۲ توکن |
| اجرای روی دستگاه | دارد | دارد |
EmbeddingGemma 2 علاوه بر پشتیبانی از چند نوع داده، عملکرد بهتری در وظایف کدنویسی ارائه میدهد. امتیاز مدل در MTEB Code به ۷۸.۶۸ رسیده، در حالی که نسل قبلی امتیاز ۶۸.۷۶ را ثبت کرده بود.
☁️ EmbeddingGemma 2 چه تفاوتی با embeddingهای ابری دارد؟
سرویسهای embedding ابری همچنان برای پروژههای بزرگ گزینه مناسبی هستند. سرورهای قدرتمند، مقیاسپذیری بالا و مدیریت ساده زیرساخت از مزیتهای این سرویسها به شمار میروند.
با این حال، همه پروژهها نمیخواهند دادههای خود را برای پردازش به یک سرویس خارجی ارسال کنند. EmbeddingGemma 2 میتواند بخشی از این نیاز را با پردازش محلی پاسخ دهد.
اجرای مدل روی دستگاه میتواند مزایایی مانند موارد زیر ایجاد کند:
- وابستگی کمتر به اینترنت
- کاهش تأخیر شبکه
- امکان پردازش دادههای حساس روی دستگاه
- کنترل بیشتر توسعهدهنده روی دادهها
- کاهش وابستگی به برخی APIهای خارجی
- امکان اجرای جستوجوی محلی بدون cloud
گوگل نیز روی کاربردهای privacy-first و پردازش کاملاً محلی تأکید کرده است.
با این حال، معماری نهایی اپلیکیشن تعیین میکند که دادهها دقیقاً کجا پردازش شوند. استفاده از EmbeddingGemma 2 به تنهایی سیاست حریم خصوصی یک محصول را مشخص نمیکند.
💾 آیا EmbeddingGemma 2 برای گوشیهای معمولی سنگین است؟
عدد ۷۴۰ میلیون پارامتر ممکن است در نگاه اول بزرگ به نظر برسد، اما تعداد پارامتر به تنهایی مصرف حافظه را مشخص نمیکند.
Quantization، نوع encoder، اندازه ورودی و سختافزار دستگاه هم روی مصرف منابع تأثیر دارند. گوگل در آزمایش Pixel 11 Pro، مصرف حدود ۱۹۱ مگابایت RAM فعال را برای حالت text-only و حدود ۵۶۷ مگابایت را برای حالت کامل چندوجهی گزارش کرده است.
این اعداد شرایط یک دستگاه مشخص را نشان میدهند و نمیتوان آنها را برای تمام گوشیهای بازار یکسان در نظر گرفت.
طراحی ماژولار مدل نیز فشار روی حافظه را کاهش میدهد. توسعهدهنده میتواند فقط encoder مورد نیاز را فعال کند. بنابراین یک اپلیکیشن جستوجوی متنی مجبور نیست بخشهای تصویر و صدا را همزمان بارگذاری کند.
🔐 آیا EmbeddingGemma 2 حریم خصوصی بیشتری دارد؟
پردازش محلی میتواند برای دادههای شخصی مزیت مهمی ایجاد کند. یک اپلیکیشن گالری را در نظر بگیرید که میخواهد امکان جستوجوی معنایی میان تصاویر را ارائه دهد.
اگر برنامه embedding را روی گوشی تولید کند، برای هر جستوجو لازم نیست تمام تصاویر را به یک سرور ابری بفرستد. چنین روشی میتواند سطح کنترل روی دادههای شخصی را افزایش دهد.
البته یک تفاوت مهم وجود دارد: قابلیت پردازش محلی مدل با سیاست حریم خصوصی اپلیکیشن یکی نیست.
توسعهدهنده ممکن است همه پردازشها را روی دستگاه انجام دهد یا بخشی از سرویس را به سرورهای آنلاین بسپارد. بنابراین برای بررسی حریم خصوصی یک محصول، باید معماری همان محصول را بررسی کرد.
🌐 آیا EmbeddingGemma 2 متنباز و رایگان است؟
گوگل EmbeddingGemma 2 را تحت مجوز Apache 2.0 منتشر کرده است. این مجوز امکان استفاده گسترده از مدل را در پروژههای مختلف فراهم میکند.
البته «رایگان بودن مدل» به معنای «رایگان بودن کل محصول» نیست. توسعهدهنده ممکن است برای اجرای زیرساخت، توسعه نرمافزار، ذخیرهسازی vectorها یا نگهداری سرویس هزینه پرداخت کند.
👨💻 چگونه میتوان از EmbeddingGemma 2 استفاده کرد؟
توسعهدهندگان میتوانند EmbeddingGemma 2 را با ابزارهای مختلف وارد پروژههای خود کنند. گوگل برای استفاده از مدل، راهنمای Sentence Transformers و ابزارهای Google AI Edge را ارائه کرده است.
شناسه مدل در Sentence Transformers برابر google/embeddinggemma-2 است. توسعهدهنده میتواند از آن برای تولید embedding مربوط به query و document استفاده کند.
برای اجرای محلی روی دستگاه نیز Google AI Edge گزینههایی مانند MediaPipe و LiteRT را معرفی کرده است. این ابزارها امکان استفاده از CPU، GPU و NPU را برای اجرای مدل فراهم میکنند.
انتخاب ابعاد embedding هم به نیاز پروژه بستگی دارد. اگر سیستم میلیونها vector ذخیره کند، استفاده از ابعاد پایینتر میتواند فضای index را کاهش دهد. در مقابل، پروژههایی که بیشترین کیفیت بازیابی را میخواهند، احتمالاً ابعاد بالاتر را ترجیح میدهند.
📊 عملکرد EmbeddingGemma 2 چقدر بهتر شده است؟
گوگل عملکرد EmbeddingGemma 2 را در benchmarkهای مختلف بررسی کرده است. این ارزیابیها حوزههایی مانند متن، کد، تصویر، سند تصویری، ویدئو و صدا را پوشش میدهند.
در MTEB Code، مدل امتیاز ۷۸.۶۸ را به دست آورده است. نسل قبلی EmbeddingGemma در همین benchmark امتیاز ۶۸.۷۶ داشت. بنابراین مدل جدید ۹.۹۲ امتیاز بهبود نشان میدهد.
این نتایج فقط به کدنویسی محدود نمیشوند. گوگل اعلام کرده است که EmbeddingGemma 2 در وظایف چندوجهی نیز نسبت کیفیت به تعداد پارامتر بالایی دارد.
با این حال، benchmark همیشه عملکرد واقعی یک مدل را در تمام پروژهها نشان نمیدهد. نوع داده، زبان، سختافزار و روش retrieval میتوانند نتیجه نهایی را تغییر دهند.
🔮 EmbeddingGemma 2 چه آیندهای برای هوش مصنوعی روی گوشی رقم میزند؟
EmbeddingGemma 2 نشان میدهد که هوش مصنوعی روی دستگاه فقط به مدلهای مولد کوچک محدود نمیشود. مدلهای embedding هم میتوانند نقش مهمی در تجربه آینده گوشیها و لپتاپها داشته باشند.
یک گوشی امروزی حجم زیادی از اطلاعات شخصی را نگه میدارد؛ از عکس و ویدئو گرفته تا فایل صوتی، سند و یادداشت. پیدا کردن یک فایل مشخص میان این حجم از دادهها همیشه ساده نیست.
مدلهای embedding میتوانند این مشکل را تا حد زیادی کاهش دهند. آنها مفهوم داده را به نمایش عددی تبدیل میکنند و به سیستم اجازه میدهند ارتباط معنایی میان فایلها را بررسی کند.
تصور کنید کاربر بپرسد:
«عکسهای سفر تابستان که کنار دریا گرفته بودم کداماند؟»
یا حتی سؤال دیگری مطرح کند:
«در کدام فایل صوتی درباره پروژه جدید صحبت کردم؟»
سیستم میتواند query را در همان فضای embedding با دادههای شخصی مقایسه کند و موارد مرتبط را پیدا کند.
وقتی چنین پردازشی روی خود دستگاه انجام شود، کاربر میتواند جستوجوی سریعتر و خصوصیتری تجربه کند. Google AI Edge نیز نمونههایی مانند Instant Media Search و Video Moments Finder را برای نمایش همین قابلیت ارائه کرده است.
EmbeddingGemma 2 در نهایت قرار نیست جای چتباتهای مولد را بگیرد. نقش این مدل بیشتر به یک موتور جستوجوی معنایی هوشمند شباهت دارد؛ موتوری که ارتباط میان انواع مختلف داده را پیدا میکند و اطلاعات مرتبط را در اختیار لایههای بعدی سیستم قرار میدهد.
❓ سوالات متداول درباره EmbeddingGemma 2
EmbeddingGemma 2 چیست؟
EmbeddingGemma 2 یک مدل embedding چندوجهی از Google DeepMind است. این مدل متن، کد، تصویر، ویدئو و صدا را به نمایشهای عددی تبدیل میکند و امکان مقایسه معنایی میان دادههای مختلف را فراهم میسازد.
EmbeddingGemma 2 چند پارامتر دارد؟
این مدل در مجموع ۷۴۰ میلیون پارامتر دارد. مدل متنی ۲۷۰ میلیون پارامتر و encoderهای بینایی و صوتی بهترتیب ۱۷۰ و ۳۰۰ میلیون پارامتر دارند.
آیا EmbeddingGemma 2 روی گوشی اجرا میشود؟
بله. گوگل مدل را برای سختافزارهای مصرفی مانند گوشی و لپتاپ توسعه داده است. آزمایش Pixel 11 Pro نیز اجرای نسخه quantized مدل را روی گوشی نشان میدهد.
آیا EmbeddingGemma 2 کاملاً آفلاین است؟
خود مدل میتواند embedding را روی دستگاه و بدون اینترنت تولید کند. با این حال، هر اپلیکیشن ممکن است برای قابلیتهای دیگر به سرویسهای آنلاین نیاز داشته باشد.
آیا EmbeddingGemma 2 یک مدل مولد است؟
خیر. مدل متن تولید نمیکند. EmbeddingGemma 2 دادهها را به embedding تبدیل میکند تا سیستم بتواند جستوجو، retrieval، دستهبندی یا مقایسه معنایی انجام دهد.
آیا EmbeddingGemma 2 برای RAG مناسب است؟
بله. توسعهدهنده میتواند مدل را در بخش embedding و retrieval یک سیستم RAG قرار دهد. ترکیب آن با یک مدل مولد مانند Gemma 4 نیز امکان ساخت RAG چندوجهی روی دستگاه را فراهم میکند.
EmbeddingGemma 2 از چند زبان پشتیبانی میکند؟
طبق اطلاعات رسمی گوگل، مدل بیش از ۱۰۰ زبان را پوشش میدهد.
آیا EmbeddingGemma 2 متنباز است؟
گوگل مدل را تحت مجوز Apache 2.0 منتشر کرده است.
آیا EmbeddingGemma 2 فقط برای متن و تصویر ساخته شده است؟
خیر. مدل متن، کد، تصویر، ویدئو و صدا را پوشش میدهد و آنها را در یک فضای embedding مشترک قرار میدهد.
جمعبندی
EmbeddingGemma 2 مدل جدید Google DeepMind برای جستوجو و بازیابی معنایی چندوجهی است. این مدل با ۷۴۰ میلیون پارامتر میتواند متن، کد، تصویر، ویدئو و صدا را در یک فضای embedding مشترک قرار دهد.
پشتیبانی از فضای ۷۶۸بعدی، context window برابر با ۸۱۹۲ توکن، معماری ماژولار و قابلیت MRL به توسعهدهندگان امکان میدهد مدل را برای سناریوهای مختلف بهینه کنند. اجرای محلی نیز یکی از مهمترین نقاط قوت محصول محسوب میشود.
جستوجوی عکس و ویدئو، پیدا کردن فایلهای صوتی، جستوجوی کد، دستهبندی اطلاعات و ساخت سیستمهای RAG تنها بخشی از کاربردهای این مدل هستند.
در نهایت، EmbeddingGemma 2 را نباید رقیب مستقیم چتباتهای مولد دانست. این مدل بیشتر نقش یک لایه هوشمند برای درک و بازیابی اطلاعات را ایفا میکند.
اگر توسعه مدلهای کوچک و چندوجهی روی دستگاه با همین سرعت ادامه پیدا کند، گوشیها و لپتاپها میتوانند به موتورهای جستوجوی شخصی قدرتمندتری تبدیل شوند؛ موتورهایی که اطلاعات کاربر را بر اساس مفهوم و ارتباط معنایی پیدا میکنند و برای بسیاری از وظایف، وابستگی کمتری به cloud دارند.
برای مشاهده جدیدترین مطالب و اخبار حوزه هوش مصنوعی، مقالات و گزارشهای مرتبط را دنبال کنید.
تازهترین مطالب فناوری و اخبار دنیای تکنولوژی را دنبال کنید.